5 Min. Lesezeit
RAG: Die Zukunft der kontextbezogenen KI
Einleitung: Von statischen LLMs zu maßgeschneiderten KI-Lösungen
Als ChatGPT Ende 2022 der breiten Öffentlichkeit zugänglich gemacht wurde, verfügte das Modell nur über Wissen bis September 2021, war also in einer Welt gefangen, die mit seinem Trainingsdatum endete. Jüngere Modelle können schon auf aktuelle Informationen aus dem Internet zugreifen. Super! Mehr Kontext, mehr Mehrwert im Moment für uns!
Doch Mehr ist nicht immer auch mehr! Gerade bei spezifischen Aufgaben, lohnt sich Fokus - dann ist weniger eben mehr! Je spezifischer die Aufgabe ist, desto mehr müssten wir die „Bibliothek“ einschränken, die ChatGPT liest, um uns eine gute Antwort geben zu können. Grundsätzlich easy, je spezifischer die Aufgabe, desto aufwendiger kann auch dies werden, jedes mal den Kontext entweder speziell zu definieren, oder eben einzuschränken.
Genau hier kommt RAG ins Spiel – eine revolutionäre Technik, die die Art und Weise, wie wir mit KI interagieren, grundlegend verändert. Mit RAG können wir der KI einen glasklaren Kontext geben - von einer einfachen Aufgabe, basierend auf 5 Dokumenten, einem Projekt mit viel Knowledge-Management-Aufwand, bis zu einem ganzen Unternehmen (z.B. Intranet).
Was ist RAG?
Retrieval-Augmented Generation (RAG) ist eine Technologie, die es ermöglicht, Large Language Models (LLMs) wie ChatGPT mit spezifischen Datenquellen zu verbinden. Im Kern funktioniert RAG wie ein “ChatGPT”, das auf Basis vorgegebener Daten antwortet, ohne dass ein spezielles, technisches Training des Modells erforderlich ist.
Anders als bei herkömmlichen KI-Systemen, bei denen das Modell ausschließlich auf sein vortrainiertes Wissen (z.B. des Internets) zurückgreift, kann RAG zusätzlich auf externe Datenquellen zugreifen und diese in seine Antworten einbeziehen. Dies ermöglicht präzisere, kontextbezogene und aktuellere Antworten auf spezifische Fragen.
Beispiel: Wir können nun eine Aufgabe stellen und 5 PDF-Dateien anhängen (z.B. Handbücher, Ausschreibungen, Berichte vergangener Projekte). Das GPT arbeitet nun mit diesen Informationen.
Warum ist RAG wichtig?
Der Mehrwert von RAG liegt in der Präzision und Relevanz seiner Antworten für spezifische Anwendungsfälle:
Präzisere Antworten: RAG liefert wesentlich genauere Antworten, die direkt auf den spezifischen Kontext zugeschnitten sind. Dies reduziert den Bedarf an Eigeninterpretation und Anpassung auf den eigenen Use Case erheblich.
Reduzierter Erklärungsbedarf: Beim Einsatz von RAG müssen wir dem System wesentlich weniger Kontext und Erklärungen liefern, da es bereits auf die relevanten Datenquellen zugreifen kann.
Weniger Beispiele nötig: Um qualitativ hochwertige Ergebnisse zu erzielen, benötigen wir deutlich weniger exemplarische Vorgaben, was Zeit spart und die Nutzung effizienter gestaltet.
Aktualität und Genauigkeit: RAG kann auf die neuesten Dokumente und Daten zugreifen, was gerade bei sich schnell ändernden Informationen einen entscheidenden Vorteil darstellt.
Wie funktioniert RAG?
Der Prozess von RAG lässt sich in wenigen Schritten beschreiben:
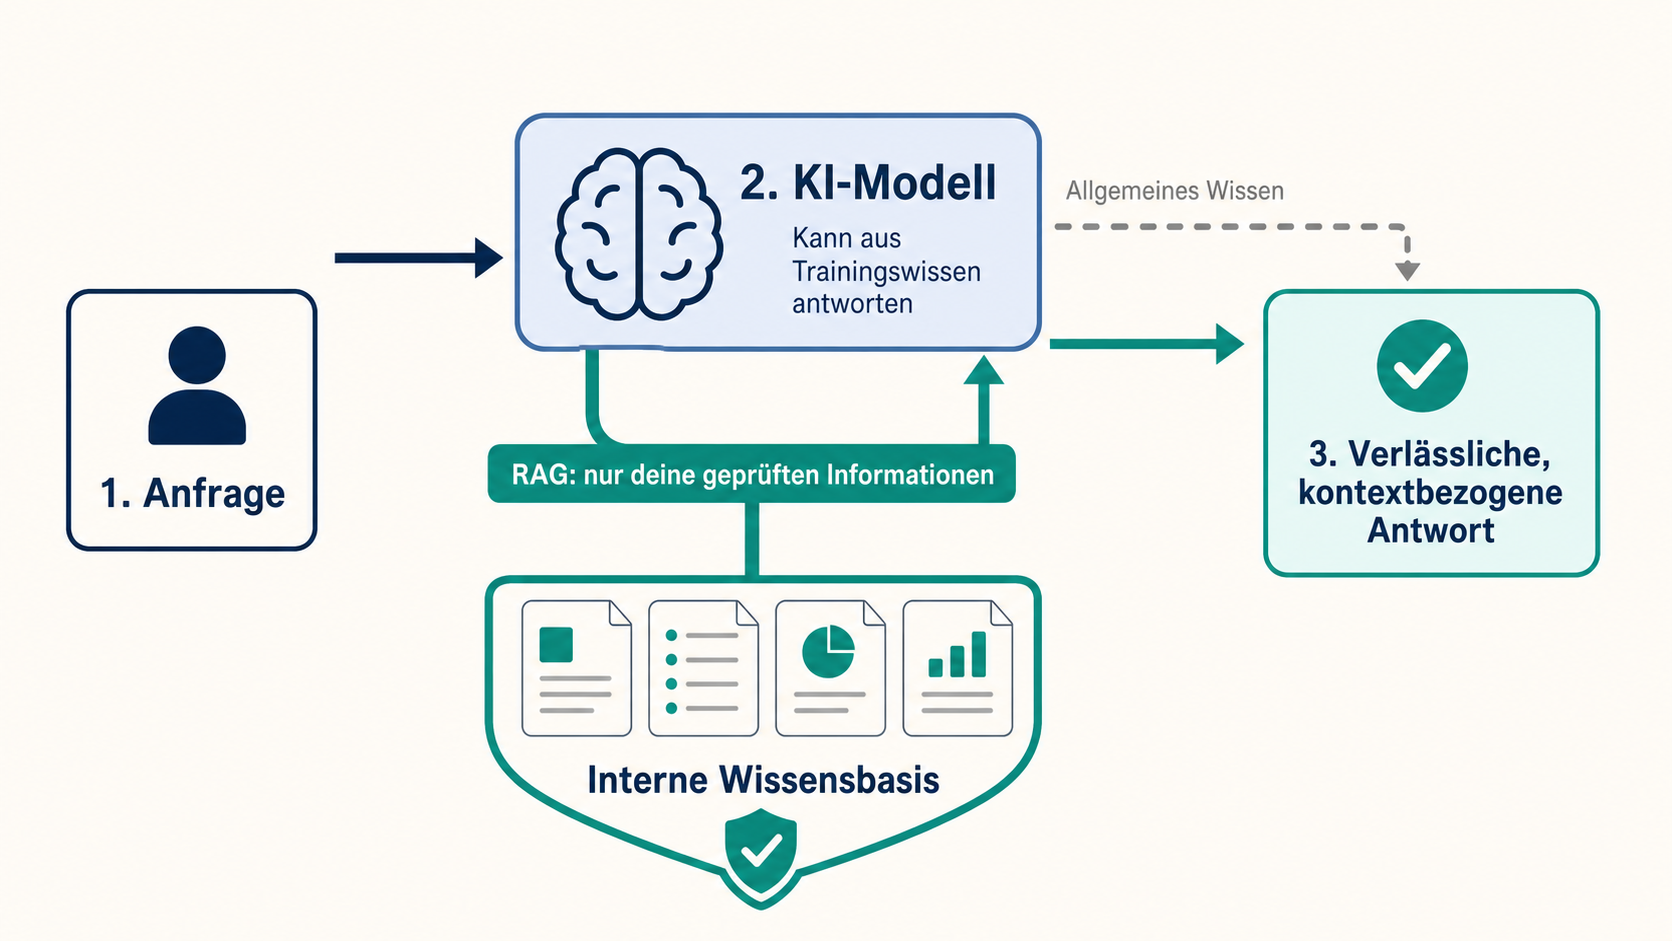
Datenanbindung: Wir verbinden eine externe Datenquelle mit dem KI-System. Dies kann eine Datenbank, ein Content-Management-System (wie ein Unternehmens-Intranet mit internen Dokumenten) oder manuell hinzugefügte Dateien (PDFs, Office-Dokumente, Bilder) sein.
Kontextbegrenzung: Es ist wichtig, den konkreten Kontext auf eine überschaubare Anzahl von Dokumenten zu beschränken, da nicht alle Modelle unbegrenzt Input verarbeiten können. Eine zu große Datenmenge könnte zudem zu unscharfen Ergebnissen führen.
Verarbeitung: Das LLM nimmt diesen spezifischen Input als Kontext und beantwortet mit seinem Sprachverständnis und seinem allgemeinen Wissen die gestellten Fragen oder Aufgaben.
Ergebnisrückgabe: Die Antworten basieren nun sowohl auf dem allgemeinen Wissen des Modells als auch auf den spezifisch bereitgestellten Informationen.
Die Rolle von Vektoren in RAG
Bei RAG wird häufig von Vektoren gesprochen – aber warum?
Stellen wir uns das Wissen eines LLM als einen riesigen Raum mit unzähligen Informationspunkten vor. Bei einer Abfrage über einen Prompt definieren wir einen Startpunkt. Von diesem Ausgangspunkt aus muss nun ein Pfeil (der Vektor) auf die gesuchte Information zeigen, die dann als Antwort zurückgegeben wird.
Die Charakteristik dieses Vektors variiert je nach Spezifität unserer Anfrage:
Allgemeine Anfrage: Bei einer allgemeinen Frage wie “Gab es in den 1990ern Programmiersprachen? Nenne mir Beispiele” ist der Vektor relativ kurz und breit. Er weist auf verschiedene passende Informationen hin, aus denen das System eine allgemeine Antwort generiert.
Präzise Anfrage: Eine spezifische Frage wie “Welche Programmiersprache hat sich in den 2010er Jahren für Datenbank-Programmierung unter Entwicklern im Silicon Valley als Favorit herausgestellt, um schnell große Datenmengen zu sammeln und zu administrieren - und warum?” erzeugt einen längeren, dünneren Vektor, der gezielt auf sehr spezifische Informationen zeigt.
Der entscheidende Vorteil von RAG liegt in der Eingrenzung des Kontextes: Indem wir den Informationsraum durch unsere bereitgestellten Dokumente einschränken, kann das System einen viel präziseren Vektor auf die gesuchte Antwort ausrichten, da es den Entstehungskontext der Frage besser versteht.
Beispiel ohne RAG: Bei der Frage nach der Performance eines spezifischen internen Projektmanagement-Tools gibt das LLM eine allgemeine Antwort basierend auf seinem Wissen über ähnliche Tools.
Beispiel mit RAG: Bei derselben Frage, aber mit Zugriff auf interne Projektdokumente und Evaluierungen, kann das System eine präzise Antwort liefern, die auf den tatsächlichen Erfahrungen und Metriken des Unternehmens basiert.
Der Mehrwert von RAG-Kenntnissen
Das Verständnis und die Anwendung von RAG bietet mehrere entscheidende Vorteile:
Effizienzsteigerung: Mit RAG können Unternehmen und Einzelpersonen schneller zu relevanten und präzisen Antworten gelangen, ohne umfangreiche Prompt-Engineering-Skills entwickeln zu müssen.
Bessere Entscheidungsgrundlagen: Durch die Kombination des allgemeinen KI-Wissens mit spezifischen Unternehmensdaten entstehen qualitativ hochwertigere Entscheidungsgrundlagen.
Kosteneffizienz: Da kein spezielles Training des Modells erforderlich ist, stellt RAG eine kosteneffiziente Alternative zu vollständig kundenspezifischen KI-Lösungen dar.
Datensicherheit: Sensible Informationen müssen nicht in das Training eines Modells einfließen, sondern werden nur bei Bedarf für spezifische Anfragen hinzugezogen.
Take Away
RAG revolutioniert die Art und Weise, wie wir mit KI-Systemen interagieren, indem es die Kluft zwischen allgemeinem KI-Wissen und spezifischen Datenanforderungen überbrückt. Es ermöglicht relevante, kontextbezogenere und präzisere Antworten ohne die Notwendigkeit eines kostspieligen und zeitaufwändigen Modelltrainings.
Für Unternehmen jeder Größe bietet RAG eine praktikable Möglichkeit, ihre internen Informationen mit der Leistungsfähigkeit moderner LLMs zu verbinden und so besser fundierte, datengetriebene Entscheidungen zu treffen. Die Technologie ist nicht nur ein Werkzeug für Experten, sondern kann von jedem genutzt werden, der spezifische Informationen aus einem umfangreichen Datenbestand extrahieren möchte.
Wer heute in RAG investiert, positioniert sich an der Spitze einer Entwicklung, die die Zukunft der Mensch-KI-Interaktion maßgeblich prägen wird.